Скрытая цена невыравненности: чем на самом деле платят за #pragma pack(1)
Перевод статьи The Hidden Cost of Misalignment — Interrupt (Memfault).
Допустим, вы делаете ещё более умный аквариум. Добавляете датчики температуры и солёности и пишете показания с метками времени во флеш. Структура и есть ваш двоичный формат записи: каждое поле лежит по фиксированному смещению, так что прочитать её можно на любой системе, которая знает раскладку.
Вы берёте типы фиксированной ширины из stdint.h и #pragma pack(1), чтобы убрать выравнивающие байты, которые вставляет компилятор. Именно этот совет я всегда получал и сам давал — и он верен, но лишь до определённого предела.
Потому что pack(1) обходится дороже, чем кажется. Он лишает компилятор возможности генерировать эффективный код для доступа к любому полю — включая поля, которые выровнены идеально.
На RISC-V одна 32-битная запись в выровненное поле структуры с pack(1) компилируется в 7 инструкций вместо одной!
В этой статье покажем, как это исправить с помощью атрибутов packed и aligned и как не допустить побайтового разбора полей, даже когда структура со временем разрастётся.
Запись с датчика#
Вот структура, какую можно встретить в любом встраиваемом проекте, — показание датчика с меткой времени, которое пойдёт во флеш или в линию связи:
#pragma pack(push, 1)
typedef struct {
    int64_t  timestamp;       // смещение 0,  8 байт
    int32_t  temperature_mc;  // смещение 8,  4 байта (миллиградусы C)
    int32_t  salinity_ppt;    // смещение 12, 4 байта (промилле)
    uint8_t  status_flags;    // смещение 16, 1 байт
    uint16_t battery_mv;      // смещение 17, 2 байта
} sensor_reading_t;           // 19 байт, без выравнивания
#pragma pack(pop)
Структура упакована, чтобы смещения полей не менялись от платформы к платформе (скажем, чтобы тот же код на C мог прочитать её на ПК), и во вторую очередь — чтобы не тратить место на байты выравнивания. Это разумно и очень распространено во встраиваемом коде.
Зачем вообще упаковывать структуры? Без упаковки компилятор вставляет между полями выравнивающие байты (padding), чтобы удовлетворить требованиям выравнивания. Исторически размер и расположение этих байтов заметно различались между архитектурами1. Современные компиляторы в этом согласованнее, но байты выравнивания по-прежнему тратят место и могут преподнести сюрприз при проектировании формата хранения или передачи. Упаковка убирает эту нестабильность: раскладка байт получается фиксированной и детерминированной, где бы ни компилировался код.
Вот как это выглядит. Неупакованная версия этой структуры занимает 24 байта — 5 байт скрытого выравнивания:
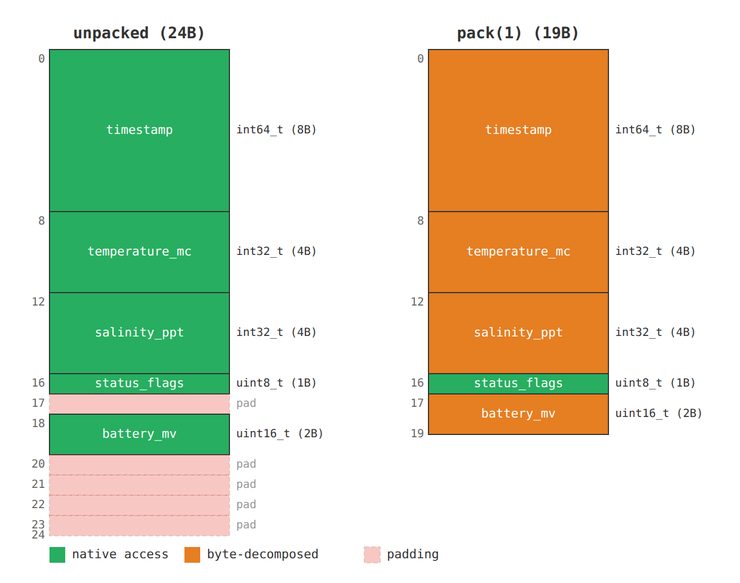
Слева — без упаковки: 5 байт выравнивания. Справа — pack(1): почти все поля разбираются на байты (byte-decomposed)
Но обратите внимание: большинство полей упакованной структуры помечены как «разбираемые на байты» — даже те, что выровнены относительно начала структуры! Это скрытая мина для производительности.
Что на самом деле генерирует компилятор#
Посмотрим на temperature_mc по смещению 8. Это 4-байтное целое, лежащее по смещению, кратному 4. Казалось бы, компилятор выдаст для записи одну инструкцию сохранения — но посмотрите, что происходит на деле.
Вот дизассемблер для RISC-V (компиляция riscv64-elf-gcc с -O2):
;; entry->temperature_mc = value;
;; value в a1, указатель на запись в a0

srli    a3, a1, 0x8       ; выделить байт 1
srli    a4, a1, 0x10      ; выделить байт 2
srli    a5, a1, 0x18      ; выделить байт 3
sb      a1, 8(a0)         ; записать байт 0
sb      a3, 9(a0)         ; записать байт 1
sb      a4, 10(a0)        ; записать байт 2
sb      a5, 11(a0)        ; записать байт 3
Семь операций! Три сдвига и четыре побайтовые записи — чтобы положить один int32_t по идеально выровненному смещению. Без pack(1):
sw a1, 8(a0) ; одна операция
Такая участь постигает каждое поле структуры. Запись 64-битного timestamp по смещению 0 ещё хуже — 14 операций вместо 2. Не только невыравненные поля. Все.
Почему так происходит.
#pragma pack(1)устанавливает максимальное выравнивание типа в 1. Значит, указатель на такую структуру может законно указывать на любой байтовый адрес. Компилятор не способен, глядя на ваш код, понять, что на практике эти структуры всегда лежат в памяти изmalloc(выровненной), на стеке (выровненном) или внутри более крупных выровненных структур. Система типов говорит: выравнивание — 1, поэтому каждый доступ разбирается на байты. Это не баг. Вы сказали компилятору: «ничему в выравнивании этой структуры не доверяй». Компилятор поверил вам на слово.
Решение: packed + aligned#
GCC и Clang позволяют совмещать __attribute__((packed)) с __attribute__((aligned(N))). Атрибут packed управляет внутренней раскладкой (никаких промежутков между полями), а aligned задаёт требование к выравниванию самой структуры:
typedef struct __attribute__((packed, aligned(4))) {
    int64_t  timestamp;       // смещение 0  -- нативный доступ
    int32_t  temperature_mc;  // смещение 8  -- нативный доступ
    int32_t  salinity_ppt;    // смещение 12 -- нативный доступ
    uint8_t  status_flags;    // смещение 16 -- побайтовый доступ в любом случае
    uint16_t battery_mv;      // смещение 17 -- по-прежнему разбирается на байты
} sensor_reading_t;           // 20 байт (19 байт данных + 1 байт хвостового выравнивания)
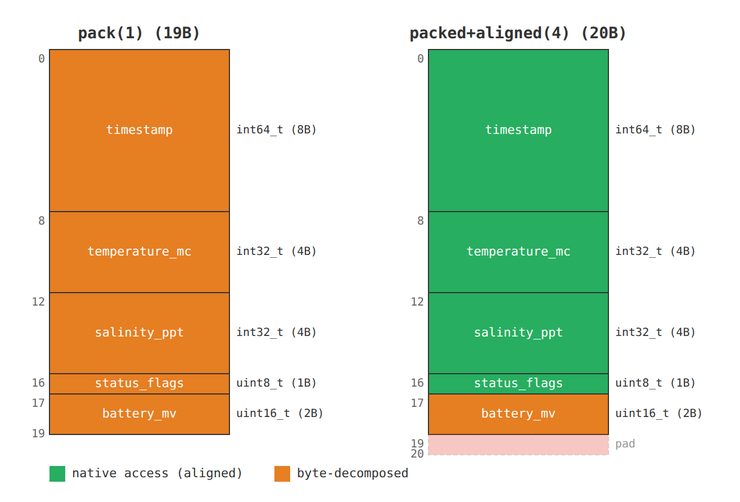
Смещения полей те же. Структура получает 1 байт хвостового выравнивания (чтобы её размер был кратен 4), но двоичная раскладка самих полей не меняется. Меняется то, что знает компилятор: базовый указатель всегда выровнен на 4 байта.
Теперь компилятор может посчитать:
timestampпо смещению 0: база, кратная 4, + 0 = выровнено. Нативная запись (2 операции).2temperature_mcпо смещению 8: кратно 4 + 8 = выровнено. Нативная запись (1 операция).salinity_pptпо смещению 12: кратно 4 + 12 = выровнено. Нативная запись.status_flagsпо смещению 16: побайтовый доступ в любом случае. Без изменений.battery_mvпо смещению 17: кратно 4 + 17 — нечётное. По-прежнему разбирается на байты — и это правильно.
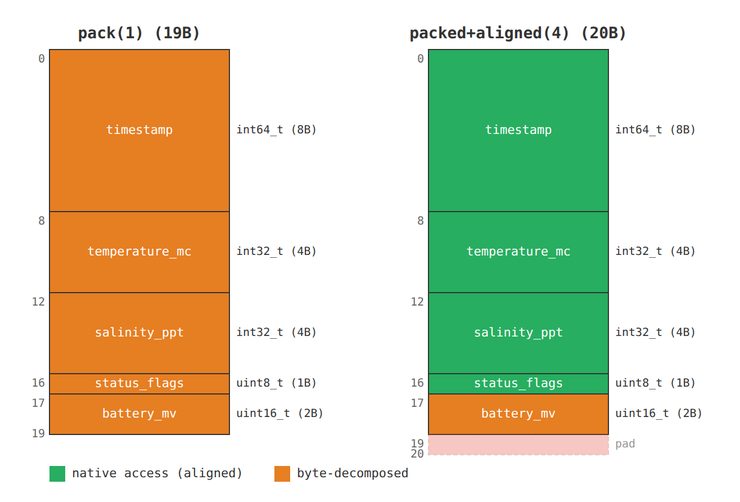
pack(1) против packed+aligned(4): зелёным — нативный доступ, оранжевым — побайтовый
Действительно невыравненное поле (battery_mv по смещению 17) по-прежнему обрабатывается безопасно3. Зато выровненные поля — а их в этой структуре большинство — обходятся уже не в 7 операций, а в одну.
Когда перейти не получится: массивы упакованных структур. Если упакованная структура уже используется в непрерывном массиве — во флеше, в файловом формате, в протоколе, — переход на
packed, aligned(4)меняет шаг массива. Элементы, лежавшие по смещениям 0, 19, 38, 57…, окажутся через каждые 20 байт. Это ломает двоичную совместимость с существующими данными.Для существующих форматов с массивами упакованных структур вы застряли с
pack(1), если не можете мигрировать данные. Для новых форматов используйтеpacked, aligned(4)с самого начала.
Вот как это выглядит на практике. С pack(1) элементы идут вплотную с шагом 19 байт. С packed, aligned(4) каждый элемент дополняется до 20 байт4, чтобы следующий начинался по смещению, кратному 4:
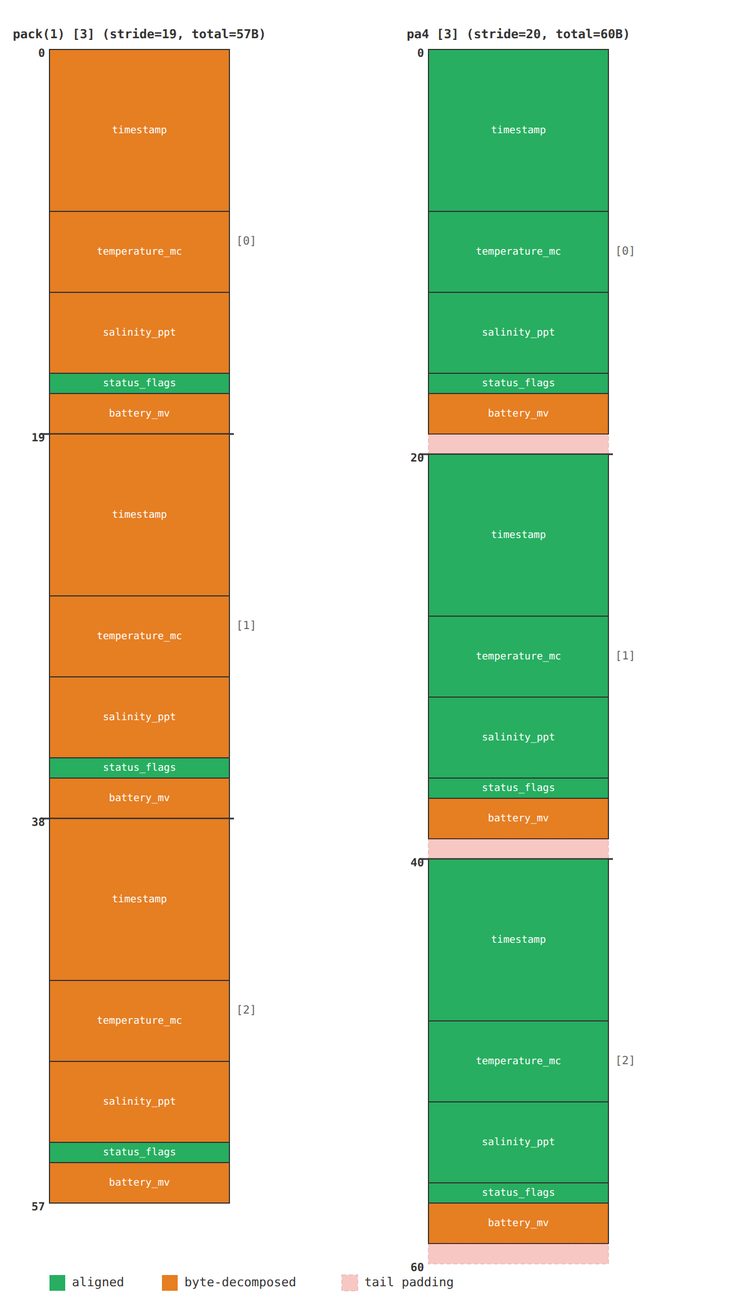
Массив из трёх элементов: pack(1) с шагом 19 байт (слева) и packed, aligned(4) — на схеме «pa4» — с шагом 20 байт (справа)
Эволюция структуры#
Структура спроектирована хорошо. Выровненные поля получают нативный доступ, невыравненные обрабатываются корректно. Вы выпускаете прошивку.
Через полгода кто-то в пул-реквесте расширяет структуру — добавляет в конец uint32_t error_code:
typedef struct __attribute__((packed, aligned(4))) {
    int64_t  timestamp;
    int32_t  temperature_mc;
    int32_t  salinity_ppt;
    uint8_t  status_flags;
    uint16_t battery_mv;
    uint32_t error_code;      // НОВОЕ -- смещение 19
} sensor_reading_t;
До этого данные занимали 19 байт, поэтому error_code попадает на смещение 19 — не кратное 4. Ни предупреждения компилятора, ни упавшего теста. Код работает. Но поле получает побайтовый разбор по полной программе:
;; entry->error_code = code;
srli    a3, a1, 0x8
srli    a4, a1, 0x10
srli    a5, a1, 0x18
sb      a1, 19(a0)
sb      a3, 20(a0)
sb      a4, 21(a0)
sb      a5, 22(a0)
Семь операций там, где должна быть одна.
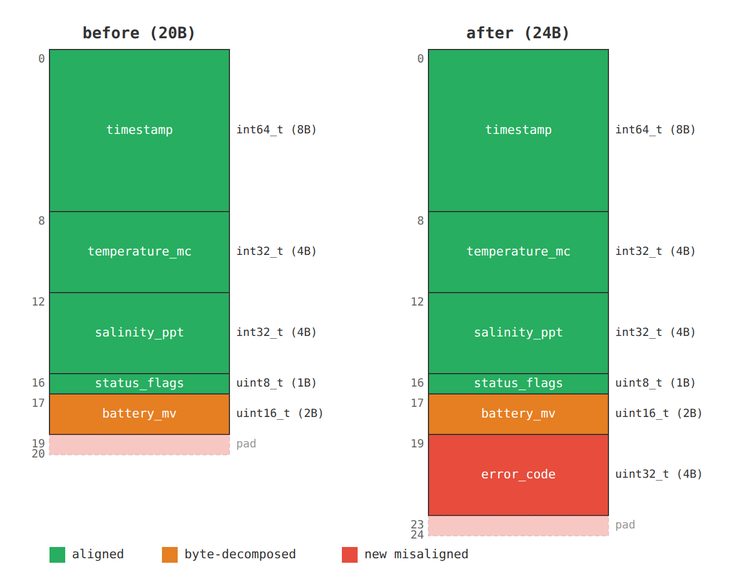
До (20 байт) и после (24 байта): новое поле error_code оказалось невыравненным
Риск посерьёзнее. Вставка полей в середину упакованной структуры ломает двоичную совместимость со всем, что уже использует старую раскладку: с устройствами в поле, сохранёнными записями, собеседниками по протоколу. Добавление в конец безопасно (старые читатели просто игнорируют лишние байты), а вставка сдвигает все последующие смещения. Я советую эшелонированную защиту: CI отклоняет вставку полей (сравнивая раскладку структур с эталоном), а интеграционные тесты декодируют пакеты или записи от старых версий прошивки. Но это тема для отдельной статьи.
Для этой конкретной структуры решение — вставить явный заполнитель перед error_code, чтобы поле попало на смещение 20:
    uint16_t battery_mv;
    uint8_t  _reserved;       // явное заполнение для сохранения выравнивания
    uint32_t error_code;      // теперь по смещению 20 -- нативный доступ
Такое легко пропустить на код-ревью — хоть человеческом, хоть автоматическом. Для этого и нужны линтеры.
Ловим невыравненность с struct-lint. struct-lint читает отладочную информацию DWARF из ELF-файлов и сообщает о полях упакованных структур, которые не выровнены естественным образом:
$ struct-lint firmware.elf

sensor_reading_evolved_t.battery_mv (uint16_t, 2 bytes) at offset 17 not naturally aligned (needs 2)
sensor_reading_evolved_t.error_code (uint32_t, 4 bytes) at offset 19 not naturally aligned (needs 4)

2 issues in 1 structs across 1 file (2 alignment, 0 missing pack)
Он ловит ровно ту тихую невыравненность, которая появляется по мере эволюции структур. Прогоните его по артефактам сборки — и узнаете, какие поля платят налог на побайтовый разбор.
Есть ещё утилита pahole, которая тоже исследует структуры по информации DWARF. Ей почти 20 лет, и она даже встроена в систему сборки ядра Linux. Вывод
paholeдля того же примераsensor_reading_evolved_t:typedef struct { int64_t timestamp; /* 0 8 */ int32_t temperature_mc; /* 8 4 */ int32_t salinity_ppt; /* 12 4 */ uint8_t status_flags; /* 16 1 */ uint16_t battery_mv; /* 17 2 */ uint32_t error_code; /* 19 4 */ /* size: 24, cachelines: 1, members: 6 */ /* padding: 1 */ /* last cacheline: 24 bytes */ } sensor_reading_evolved_t __attribute__((__aligned__(4)));Здесь видны смещения и размеры всех членов структуры. Такой вывод полезен для отладки и ручного осмотра структур, а ещё у
paholeесть флаги, с которыми он предлагает перестроить структуру ради производительности.struct-lintже задуман как линтер для CI-конвейера: он выдаёт в stdout сообщения в стиле ошибок компилятора, чтобы на них было максимально удобно реагировать и разработчикам, и ИИ-агентам.
Не только RISC-V#
Примеры выше — для RISC-V, но проблема касается всех встраиваемых архитектур. Вот та же 32-битная запись (temperature_mc по смещению 8) на семи целевых платформах:
| Архитектура | pack(1) | packed, aligned(4) | Соотношение |
|---|---|---|---|
| RISC-V 32 (rv32imac) | 7 операций (3 srli + 4 sb) | 1 операция (sw) | 7× |
| Xtensa (ESP32) | 7 операций (3 extui + 4 s8i) | 1 операция (s32i.n) | 7× |
| ARM Cortex-M0 | 7 операций (2 lsrs + lsls + 4 strb) | 1 операция (str) | 7× |
| MIPS32 | 2 операции (swl + swr) | 1 операция (sw) | 2× |
| macOS arm64 | 1 операция (str) | 1 операция (str) | 1× |
| i686 | 1 операция (movl) | 1 операция (movl) | 1× |
| x86_64 | 1 операция (movl) | 1 операция (movl) | 1× |
Большинство проверенных встраиваемых платформ показывают одинаковый семикратный оверхед от побайтового разбора — разные системы команд, разные компиляторы, одна и та же картина. Исключение — MIPS32: у него есть специальные инструкции невыравненной записи (swl / swr), которые сокращают оверхед до 2×.
Настольные архитектуры (arm64, x86) генерируют одинаковый код независимо от упаковки. Они обрабатывают невыравненный доступ аппаратно и могут платить за это на уровне микроархитектуры (пересечение границы кэш-линии, лишние такты) — но на встраиваемых платформах, к счастью, достаточно заглянуть в дизассемблер, чтобы точно знать, чем мы платим.
Итог#
#pragma pack(1) — грубый инструмент. Он говорит компилятору: «ничему в выравнивании этой структуры доверять нельзя». В большинстве встраиваемых проектов это куда пессимистичнее реальности: вы упаковали структуру ради стабильной двоичной раскладки для сериализации, а не потому, что действительно обращаетесь к ней через невыравненные указатели.
Используйте __attribute__((packed, aligned(4))), чтобы сказать то, что вы на самом деле имеете в виду: между полями промежутков нет, но сама структура лежит по выровненному адресу. Код станет меньше и быстрее, а поля, которым это действительно нужно, компилятор по-прежнему корректно разберёт на байты.
По мере эволюции структур выравнивание может незаметно деградировать. Одно новое поле не по тому смещению — и вы снова платите семикратно, а компилятор молчит. Линтуйте это так же, как линтуете всё остальное.
По отдельности это мелкие выигрыши — единицы процентов по размеру кода и производительности. Но мастерство во встраиваемой разработке — это накопление таких деталей. Сделать мелочи правильно, чтобы компилятор мог выполнить свою работу, — так и получаются быстрые, компактные и корректные системы.
Ссылки#
- struct-lint: линтер выравнивания структур на основе DWARF
- GCC Type Attributes: packed, aligned
- ARM Cortex-M0 Technical Reference Manual: Unaligned Access
Ещё одна забота о переносимости при проектировании двоичных форматов — порядок байтов; см. отступление о переносимости записей в статье про встраиваемые базы данных. Здесь же сосредоточимся на том, что
pack(1)делает с генерируемым кодом. ↩︎В 32-битной системе команд нет единой инструкции 64-битной записи, так что две 32-битные записи — уже оптимум, и
aligned(4)достаточно. Если вы целитесь в 64-битное ядро (например, RV64 или AArch64) и хотите одну инструкциюsdилиstr, используйтеaligned(8). ↩︎Есть бонус и для невыравненного чтения. С
pack(1)чтениеbattery_mvтребует двух побайтовых загрузок и сборки значения (4 операции). Сpacked, aligned(4)компилятор знает, что смещение 16 кратно 4, поэтому загружает оттуда одно слово и сдвигом выделяетuint16_t(3 операции). Знание того, где проходят границы выравнивания, позволяет компилятору использовать более широкие загрузки даже для невыравненных полей. ↩︎Небольшой бонус: индексирование массива с шагом 20 байт быстрее, чем с шагом 19. Умножение на 20 раскладывается на простые сдвиги и сложения, а умножение на 19 требует дополнительного вычитания. Разница невелика, но достаётся бесплатно. ↩︎