Устройство упало в поле: разбираем coredump Zephyr с помощью Spotflow

Перевод статьи My device crashed in the field. How do I figure out why? — Rakhshan Sayed.
Для обычных программных ошибок логов часто хватает. Но когда встраиваемая система ловит неустранимый сбой, одних сообщений в логе обычно мало: к моменту перезагрузки состояние, которое привело к падению, уже утеряно. Разбираемся, как настроить сбор coredump в Zephyr RTOS и анализировать падения удалённо — уже после того, как устройство перезагрузилось.
Отчёт о падении (coredump) в Spotflow
Классическая отладка встраиваемых систем обычно требует воспроизвести сбой с подключённым отладчиком — а это часто невозможно, когда устройство уже установлено у заказчика.
Здесь и пригождаются coredump’ы. Coredump сохраняет информацию о состоянии системы непосредственно перед падением и позволяет разработчику восстановить картину произошедшего уже после перезагрузки устройства.
В этой статье я покажу, как настроить Spotflow на загрузку coredump’ов с платы FRDM-MCXN947 под управлением Zephyr RTOS, и разберу, как с их помощью анализировать реальные падения удалённо.
Что такое coredump#
Представьте: вы отлаживаете ошибку в прошивке, и устройство внезапно падает.
Сторожевой таймер перезагружает систему, вывод в UART обрывается, а когда устройство снова выходит на связь, информации для диагностики уже нет. Содержимое RAM может быть перезаписано при старте, регистры процессора потеряны, а воспроизвести сбой под отладчиком на развёрнутом устройстве, скорее всего, не получится.
Coredump решает эту проблему: он фиксирует снимок системы в момент падения. Вместо простого «прошивка упала» он сохраняет достаточно сведений, чтобы восстановить, что именно делал процессор непосредственно перед сбоем.
В зависимости от настроек coredump в Zephyr может содержать:
- значения регистров процессора (счётчик команд, указатель стека, регистр связи и т. д.);
- поток, который выполнялся в момент падения;
- содержимое стека;
- выбранные области RAM;
- глобальные и статические переменные;
- исключение или сбой, из-за которого система остановилась.
Обычно эти данные записываются в энергонезависимую память до перезагрузки. После рестарта coredump можно загрузить и проанализировать позже — даже если к устройству давно не подключён отладчик.
В предыдущей статье мы настроили Spotflow на сбор логов с работающей FRDM-MCXN947 по Ethernet. Это дало отличную видимость нормальной работы приложения, но при намеренном падении прошивки через k_panic() или k_oops() в Spotflow поначалу появлялось лишь событие «Device disconnected». Никаких сведений о том, почему устройство упало.
Чтобы анализ падений стал осмысленным, нужно сначала настроить Zephyr на генерацию coredump’ов и указать, где их хранить. После этого Spotflow сможет автоматически загружать информацию о падении после перезагрузки платы, и в его панели можно будет смотреть трассировку стека, значения регистров, глобальные переменные и даже анализ падения с помощью ИИ.
Намеренно роняем устройство#
Разобравшись, что такое coredump и зачем он нужен, я намеренно уронил приложение, чтобы посмотреть, как Spotflow обработает это событие.
Для имитации неустранимого сбоя я изменил приложение так, чтобы после короткого периода нормальной работы оно вызывало API Zephyr k_panic():
LOG_ERR("Triggering intentional crash...");
k_sleep(K_SECONDS(10));
k_panic();
В отличие от обычных ошибок времени выполнения, k_panic() немедленно прерывает нормальное выполнение и передаёт управление обработчику фатальных ошибок Zephyr. Это удобный способ проверить, что вся цепочка отчётов о падениях работает, не дожидаясь настоящего бага.
После прошивки изменённого кода устройство повело себя ровно так, как ожидалось: сразу после паники оно перезагрузилось. На первый взгляд всё работало.
Неожиданный результат#
Однако, открыв панель Spotflow, я увидел нечто неожиданное. Вместо сообщения о падении Spotflow показал только системное событие «Device disconnected».
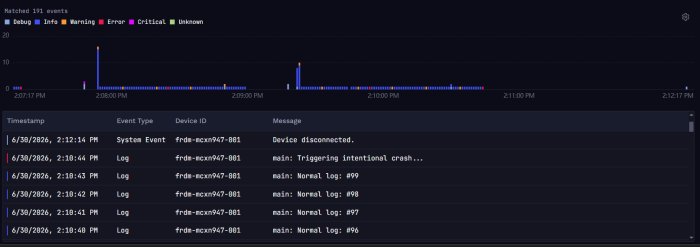
Вместо отчёта о падении — только «Device disconnected»
Последнее сообщение лога («Triggering intentional crash…») благополучно дошло до Spotflow, но ни отчёта о падении, ни трассировки стека, ни указания на причину сброса не было. С точки зрения Spotflow устройство просто исчезло.
Сразу возник важный вопрос: если Zephyr упал, почему Spotflow не распознаёт это как падение?
Почему Spotflow не увидел падение#
Ответ оказался довольно простым. Хотя в Zephyr есть встроенная поддержка coredump, на FRDM-MCXN947 она по умолчанию выключена. Без настроенного coredump у операционной системы нет механизма, который сохранил бы состояние процессора перед перезагрузкой.
В результате Spotflow не получает никаких данных о падении. Устройство просто отключается, перезагружается и подключается снова — и это событие выглядит почти так же, как неожиданная потеря питания.
Чтобы включить отчёты о падениях, нужно настроить две вещи:
- Включить подсистему coredump в Zephyr через Kconfig.
- Зарезервировать энергонезависимую память для хранения coredump перед сбросом платы.
Добавляем Spotflow SDK#
Перед настройкой coredump нужно добавить Spotflow SDK в рабочее пространство Zephyr. Для этого репозиторий Spotflow прописывается в манифесте рабочего пространства (west.yml):
manifest:
  projects:
    - name: spotflow
      revision: main
      path: modules/lib/spotflow
      url: https://github.com/spotflow-io/device-sdk
После этого west update скачивает Spotflow SDK в рабочее пространство. Теперь у проекта есть доступ к библиотекам Spotflow, сетевым помощникам, бэкенду логирования и функциональности coredump, которые используются далее в статье.
Включаем coredump в Spotflow#
Интегрировав Spotflow SDK в проект, я включил поддержку coredump в Zephyr. Spotflow предоставляет несколько опций Kconfig, расширяющих встроенную подсистему coredump: они позволяют собирать информацию о падении и загружать её после перезагрузки устройства.
В prj.conf были добавлены следующие опции:
CONFIG_SPOTFLOW_COREDUMPS=y
CONFIG_DEBUG_COREDUMP_THREADS_METADATA=y
CONFIG_DEBUG_COREDUMP_MEMORY_DUMP_THREADS=y
Первая опция включает интеграцию coredump со Spotflow, а остальные велят Zephyr добавлять в coredump дополнительные сведения о работающих потоках и их памяти. Этот дополнительный контекст сильно повышает ценность посмертной отладки, сохраняя больше состояния системы на момент падения.
Казалось, всё настроено правильно, и я ожидал, что Spotflow начнёт автоматически сообщать о падениях. Увы, вышло иначе.
Первая попытка#
Для проверки конфигурации я изменил приложение так, чтобы после нескольких секунд нормальной работы оно намеренно вызывало панику ядра:
LOG_INF("Triggering intentional crash...");
k_panic();
Но при сборке прошивки для FRDM-MCXN947 процесс сразу завершился ошибкой:
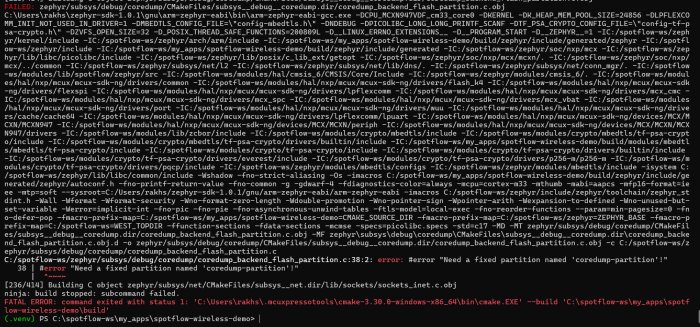
Сборка падает с ошибкой об отсутствующем разделе
#error "Need a fixed partition named 'coredump-partition'!"
Поначалу ошибка озадачивала. Ни одна из опций Kconfig не упоминала раздел flash-памяти, и разметку памяти платы я не трогал. Так почему же Zephyr вдруг требует раздел с именем coredump-partition?
Почему сборка не прошла#
Вывод компилятора указывал, где именно возникла ошибка. Перейдя к файлу C:/spotflow-ws/zephyr/subsys/debug/coredump/coredump_backend_flash_partition.c, я нашёл участок, относящийся к ошибке:
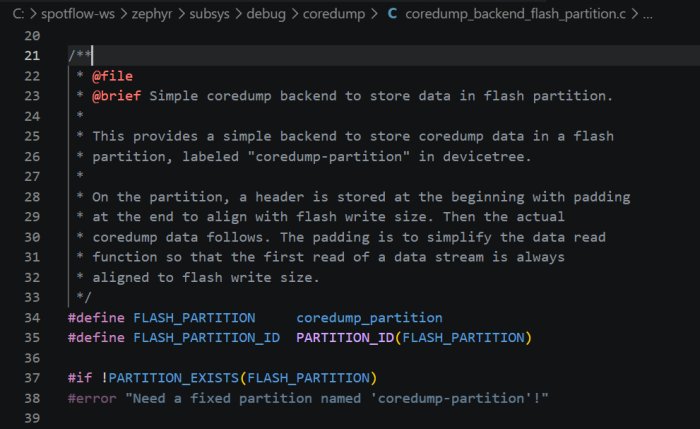
Фрагмент бэкенда coredump, хранящего данные во flash
Исходник сразу объясняет проблему: этот бэкенд хранит данные coredump в разделе flash-памяти и ожидает, что в Devicetree существует раздел с меткой coredump-partition. Перед компиляцией препроцессор проверяет, определён ли такой раздел:
#define FLASH_PARTITION coredump_partition

#if !PARTITION_EXISTS(FLASH_PARTITION)
#error "Need a fixed partition named 'coredump-partition'!"
#endif
Вот и недостающий кусок. В штатном Devicetree моей платы не было раздела coredump-partition, поэтому препроцессор намеренно остановил сборку ещё до компиляции кода. Раз нужного раздела нет, следующим шагом было расширить Devicetree платы с помощью overlay-файла.
Добавляем Devicetree overlay#
Поняв, почему сборка не проходит, я увидел и решение. Бэкенду coredump просто нужно место в энергонезависимой памяти, куда будут записываться данные о падении.
Однако запись во flash ставит важный вопрос: где именно хранить coredump? По умолчанию Devicetree платы FRDM-MCXN947 не резервирует под coredump никакого места во flash. Поэтому у Zephyr нет безопасного места для записи информации о падении — именно из-за этого и не проходила сборка.
Решение — расширить Devicetree платы через overlay. В отличие от правки исходных файлов Devicetree платы, overlay позволяет приложению добавлять или переопределять конфигурацию оборудования, не меняя сам Zephyr. Во время сборки Zephyr автоматически объединяет overlay с существующим Devicetree платы и получает итоговое описание оборудования для приложения.
Я добавил такой overlay:
&w25q64jvssiq {
    partitions {
        storage_partition: partition@0 {
            label = "storage";
            reg = <0x0 0x700000>;
        };

        coredump_partition: partition@700000 {
            label = "coredump-partition";
            reg = <0x700000 0x100000>;
        };
    };
};
Этот overlay определяет два фиксированных раздела на внешней 8-мегабайтной flash-памяти Winbond, установленной на плате.
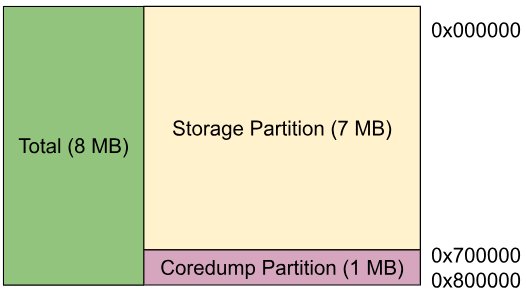
Разметка внешней flash-памяти
Первые 7 МБ отводятся под общее хранилище приложения, а последний 1 МБ — исключительно под coredump’ы.
Метка раздела тоже важна. Выше мы видели, что система сборки Zephyr явно проверяет наличие раздела с именем coredump-partition. Когда overlay его определяет, проверка на этапе компиляции проходит, и бэкенд coredump точно знает, куда записывать данные о падении.
Собираем приложение снова#
С overlay-файлом я пересобрал проект в расчёте, что проблема решена. На этот раз приложение скомпилировалось без ошибок: Zephyr смог найти нужный раздел coredump-partition.
После прошивки обновлённого кода и очередной намеренной паники Spotflow сразу обнаружил, что устройство упало. Панель больше не сообщала только «Device disconnected» — теперь появился отчёт о падении с информацией, извлечённой прямо из захваченного coredump.
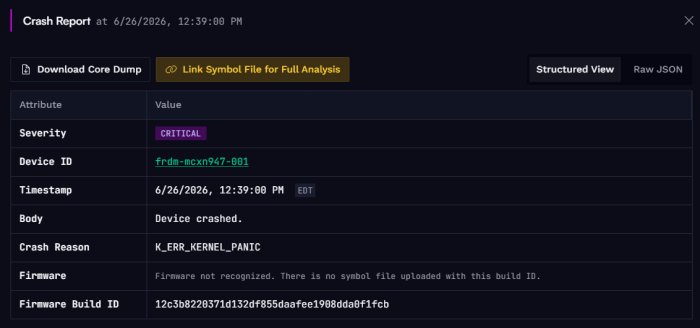
Spotflow распознал падение и сформировал отчёт
Даже до загрузки файла символов прошивки (.elf) отчёт уже содержит ценную низкоуровневую информацию. Например, Spotflow показывает значения регистров процессора ровно такими, какими они были в момент исключения.
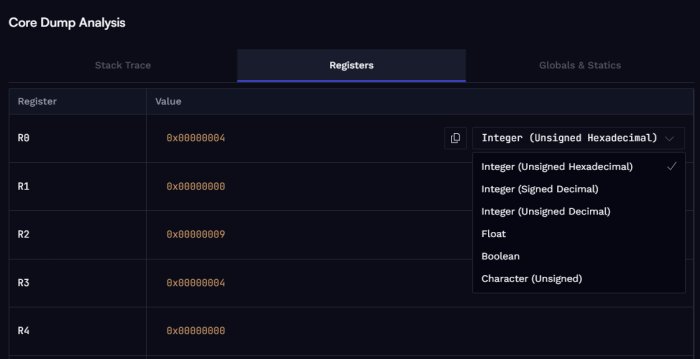
Регистры процессора на момент исключения
Эти регистры отражают состояние выполнения CPU в момент падения и часто дают первые подсказки о том, что делал процессор непосредственно перед остановкой.
Помимо «сырых» шестнадцатеричных значений, Spotflow позволяет смотреть каждый регистр в нескольких форматах — так проще интерпретировать адреса, знаковые и беззнаковые целые и другие представления при отладке.
Информация уже полезная, но значения регистров — это всё ещё просто числа. Чтобы понять, каким функциям, переменным и строкам исходного кода соответствуют эти адреса, нужно передать Spotflow файл символов прошивки.
Загружаем символы прошивки#
Хотя Spotflow уже успешно захватывал coredump’ы, в отчёте о падении не хватало важной информации — имён символов.
Без информации о символах захваченный стек состоит в основном из «сырых» адресов памяти. Значения регистров и содержимое памяти доступны, но чтобы понять, какие функции выполнялись, нужна дополнительная отладочная информация.
Zephyr генерирует её при каждой сборке:
build/
└── zephyr/
    └── zephyr.elf
В отличие от образа прошивки (zephyr.bin), который записывается в плату, zephyr.elf содержит отладочные символы: имена функций, глобальные переменные и привязку к исходному коду.
Создав в Spotflow версию прошивки, я загрузил сгенерированный zephyr.elf. Spotflow использует его исключительно как таблицу соответствия, переводящую адреса памяти в имена функций, исходные файлы и переменные.
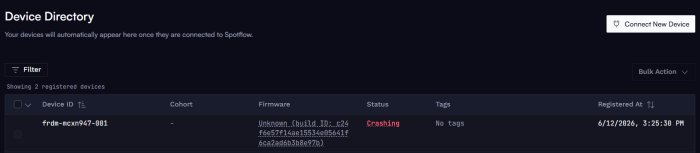
Загрузка ELF-файла с символами
После загрузки Spotflow смог связывать будущие coredump’ы с этой версией прошивки. Кстати, когда появляется очередной отчёт о падении, .elf можно загрузить прямо из Spotflow, не разыскивая файлы вручную в папке проекта.
Анализируем падение#
С загруженными символами я в последний раз пересобрал приложение и снова намеренно вызвал панику ядра.
На этот раз отчёт выглядел совсем иначе. Вместо простого «устройство отключилось» Spotflow восстановил из coredump достаточно сведений о состоянии процессора для полноценного посмертного анализа. Теперь мне не нужно было полагаться только на логи UART и догадки — информации хватало, чтобы точно разобраться, что случилось перед падением.
Разбираемся с исключением#
Первым делом я посмотрел на сводку по исключению.
Spotflow определил, что прошивка завершилась из-за того, что Zephyr вошёл в панику ядра. В этом примере мы сами вызвали k_panic(), чтобы проверить цепочку coredump, так что результат ожидаемый.
В реальном приложении эта сводка часто даёт первое указание на настоящую причину падения. В зависимости от сбоя там может оказаться переполнение стека, недопустимый доступ к памяти, сработавший assert или другое неустранимое исключение.
Знать, почему ОС остановилась, — важный первый шаг, но он ещё не говорит, где находилось выполнение в момент падения.
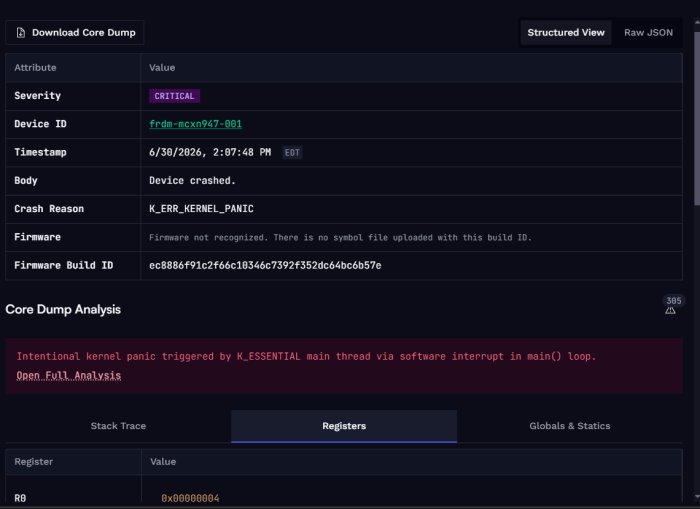
Сводка по исключению: паника ядра
Идём по стеку вызовов#
Когда я расследую падение прошивки, следующим я обычно смотрю на трассировку стека.
Трассировка стека восстанавливает последовательность вызовов функций, активных непосредственно перед остановкой. Без отладочных символов это были бы почти сплошь «сырые» адреса памяти. Но поскольку файл символов загружен, Spotflow смог сопоставить адреса с понятными именами функций и местами в исходном коде.
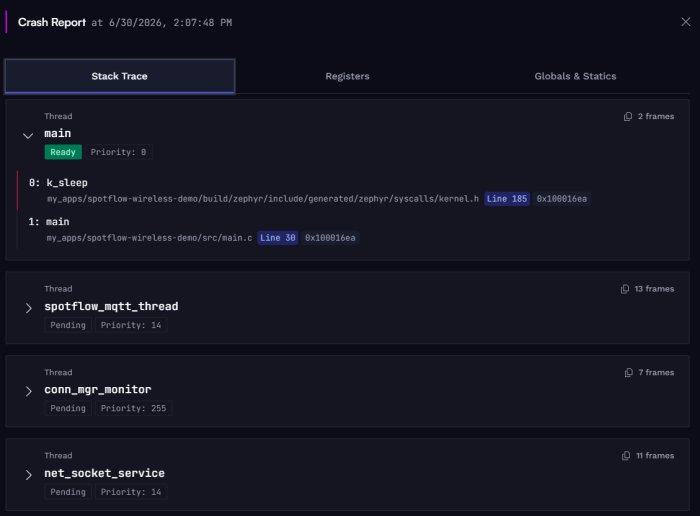
Трассировка стека с разрешёнными символами
В этом примере видно, что главный поток выполнялся внутри k_sleep(), вызванной из main(). Здесь всего два кадра стека, но в реальных встраиваемых приложениях стек вызовов часто гораздо глубже и охватывает несколько слоёв приложения.
Возможность восстановить цепочку вызовов бесценна, когда нужно проследить неожиданное падение до кода, который его в итоге вызвал.
Трассировка стека показывает, как выполнение дошло до сбоя, но мне хотелось понять и то, в каком состоянии был сам процессор в момент остановки.
Изучаем состояние процессора#
Для этого я обратился к регистрам процессора.
Spotflow сохраняет регистры CPU ровно такими, какими они были захвачены перед перезагрузкой устройства. Такие регистры, как счётчик команд (PC), регистр связи (LR) и указатель стека (SP), дают снимок того, что выполнял процессор, куда он собирался вернуться и в каком состоянии был текущий стек.
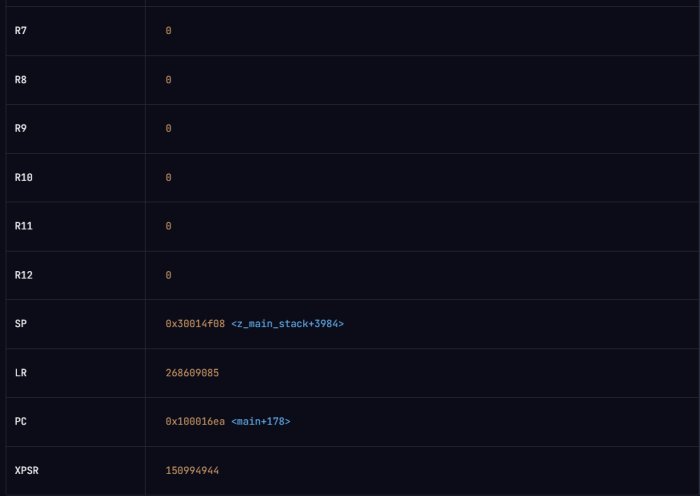
Состояние процессора на момент падения
Тем, кто привык работать с отладчиком, всё это должно быть знакомо. Ключевое отличие в том, что плата больше не обязана быть подключена к компьютеру разработчика. Состояние процессора захватывается автоматически при падении, сохраняется во flash, загружается после перезагрузки и становится доступным удалённо через Spotflow.
Регистры объясняют состояние CPU в момент падения, но сами по себе они редко бывают причиной. Чтобы понять, почему программа пришла в это состояние, часто нужно заглянуть в данные самого приложения.
Смотрим переменные и память#
Поскольку загруженный файл символов содержит и отладочную информацию, Spotflow может сопоставить части захваченной памяти с переменными, определёнными в приложении.
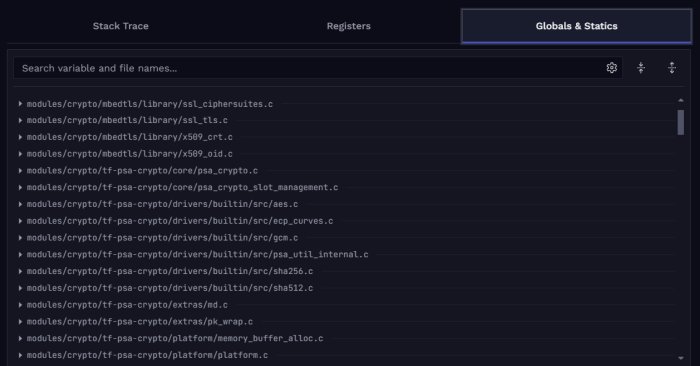
Переменные, восстановленные из coredump
В зависимости от настройки подсистемы coredump в Zephyr сюда могут входить глобальные и статические переменные, информация о потоках, содержимое стеков и выбранные области RAM. Вместо голой памяти Spotflow показывает эти данные в виде, который намного проще соотнести с исходным приложением.
Возможность изучить состояние приложения после развёртывания — одно из главных преимуществ coredump перед обычным логированием. Логи рассказывают, что происходило до падения, а coredump часто показывает, почему оно произошло.
К этому моменту я восстановил большую часть состояния системы. Оставалось сложить всю эту информацию в единую картину.
Анализ с помощью ИИ#
Одна из функций, показавшихся мне особенно интересными, — анализ падения с помощью ИИ.
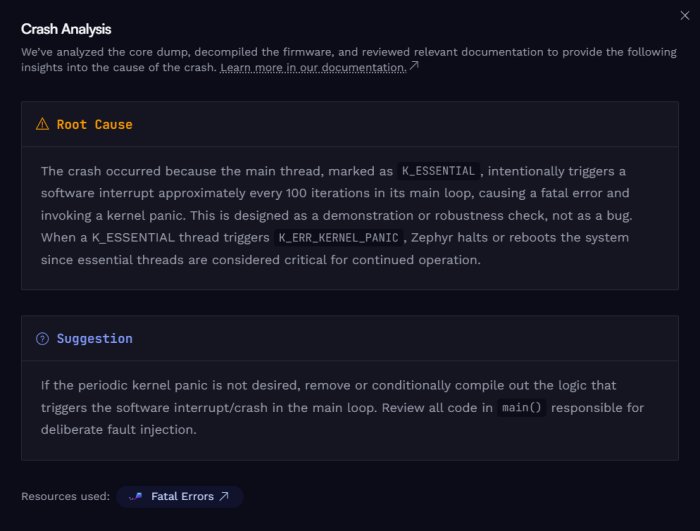
Сводка, сгенерированная ИИ
Вместо того чтобы вручную сводить воедино сведения об исключении, трассировку стека, значения регистров и захваченные переменные, Spotflow генерирует сводку с вероятной причиной падения и выделяет самые важные части coredump.
Я не считаю это заменой понимания самой прошивки или полноценного расследования. Скорее это ещё один инструмент, который помогает направить поиск в нужную сторону — особенно при работе с незнакомой кодовой базой или при сортировке отчётов о падениях с развёрнутых устройств.
Собираем всё вместе#
Поработав с этим примером, я заметил, что каждый раз анализирую падение примерно по одной и той же схеме:
- Читаю сводку по исключению, чтобы понять, почему Zephyr остановил выполнение.
- Изучаю трассировку стека, чтобы определить, какой поток и какие функции были активны.
- Смотрю регистры процессора, чтобы понять состояние выполнения CPU.
- Просматриваю захваченные переменные и память, чтобы понять, что делало приложение.
- Использую сгенерированную ИИ сводку как дополнительное подспорье при интерпретации собранных данных.
По отдельности каждая из этих частей полезна. Вместе они восстанавливают достаточно состояния системы, чтобы осмысленная отладка после перезагрузки стала возможной — даже когда устройство уже упало.
Заключение#
До настройки coredump намеренное падение прошивки давало в Spotflow лишь событие «Device disconnected». Устройство благополучно перезагружалось, но объяснить причину падения было практически нечем.
После включения подсистемы coredump в Zephyr, резервирования отдельного места через Devicetree overlay и загрузки файла символов то же самое падение превратилось в подробный отчёт с трассировкой стека, регистрами процессора, переменными и привязкой к исходному коду.
Главный вывод даже не в том, что Spotflow показывает отчёты о падениях, а в том, что coredump’ы принципиально меняют подход к отладке развёрнутых встраиваемых систем. Вместо надежды воспроизвести сбой с подключённым отладчиком разработчик может получить нужную информацию прямо с устройств, работающих в поле, и сразу начать расследование.