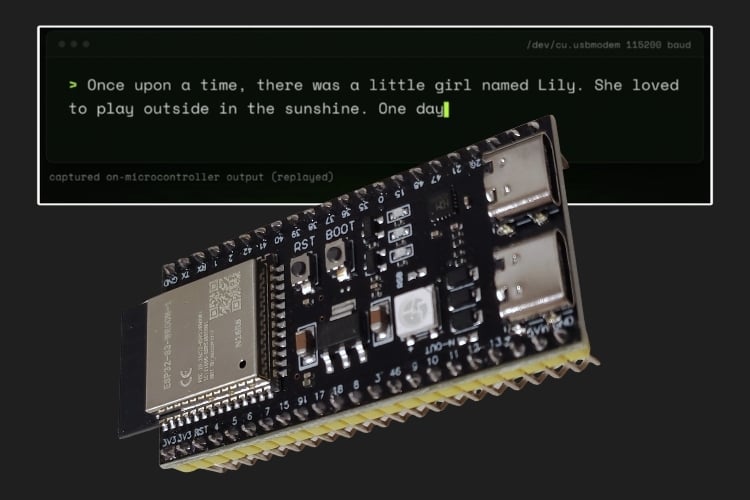
Разработчик slvDev запустил языковую модель на 28,9 млн параметров прямо на ESP32-S3 (~$8), без отправки данных на сервер, на скорости ~9 токенов/с. Секрет — Per-Layer Embeddings из моделей Google Gemma: огромная таблица эмбеддингов лежит во флеше, а в SRAM держится лишь лёгкая вычислительная часть.
ESP32-S3 запускает LLM на 28,9 млн параметров — с трюком из Google Gemma